---
title: "Sarcopenia y necesidades de cuidados paliativos"
subtitle: "Análisis de datos SARC-F y SPARC-Sp"
author: "JA Calvache"
lang: es
format:
html:
toc: true
toc-depth: 3
code-fold: true
code-tools: true
df-print: paged
execute:
warning: false
message: false
editor: visual
editor_options:
chunk_output_type: console
---
## Objetivos
**Objetivo general.** Estimar la asociación entre sarcopenia, medida con el instrumento SARC-F, y las necesidades holísticas no satisfechas de cuidados paliativos, determinadas con SPARC, en pacientes con enfermedades crónicas no transmisibles oncológicas y no oncológicas del Hospital Universitario San José entre 2021 y 2022. Este objetivo es exploratorio y no causal.
**Objetivos específicos**
1. Describir las características sociodemográficas de los pacientes con enfermedades crónicas no transmisibles oncológicas y no oncológicas.
2. Describir la prevalencia de sarcopenia, definida por un puntaje SARC-F \> 4 puntos.
3. Determinar la prevalencia de necesidades holísticas no satisfechas y estratificarla por dominio de la herramienta SPARC-Sp.
4. Diseñar una estrategia de visualización apropiada para reportar las necesidades holísticas no satisfechas valoradas con SPARC-Sp.
**Pregunta de investigación (PECO).** En pacientes con enfermedades crónicas no transmisibles, ¿existe asociación entre la presencia de sarcopenia (SARC-F) y las necesidades no satisfechas (SPARC)?
## 1. Configuración
Todas las librerías se cargan aquí, una sola vez. También se definen los objetos que se reutilizan en el documento: la definición de los dominios SPARC y las paletas de colores.
```{r}
#| label: setup
library(readxl)
library(tidyverse)     # dplyr, tidyr, ggplot2, forcats, purrr
library(summarytools)  # dfSummary
library(gtsummary)     # tablas descriptivas y de regresión
library(gt)
library(binom)         # IC de Wilson
library(performance)   # check_model, model_performance
library(see)           # gráficos de check_model
library(ggpubr)        # stat_compare_means
library(fmsb)          # radarchart

# Definición de los 6 dominios SPARC presentes en la base:
# ítems que lo componen y puntaje máximo posible (n ítems × 3)
dominios <- tribble(
  ~var,         ~nombre,                            ~items,
  "sparc_fis",  "Síntomas físicos",                 paste0("s", 2:22),
  "sparc_psic", "Temas psicológicos",               paste0("s", 23:31),
  "sparc_rel",  "Temas religiosos y espirituales",  paste0("s", 32:33),
  "sparc_inde", "Independencia y actividad",        paste0("s", 34:36),
  "sparc_fami", "Asuntos familiares y vida social", paste0("s", 37:40),
  "sparc_tra",  "Tratamiento",                      paste0("s", 41:42)
) %>%
  mutate(
    var_p  = paste0(var, "_p"),          # nombre de la versión ponderada (0–100)
    maximo = lengths(items) * 3
  )

# Etiquetas legibles: c(sparc_fis_p = "Síntomas físicos", ...)
etiquetas_dominio <- set_names(dominios$nombre, dominios$var_p)

items_sparc <- paste0("s", 2:42)
items_sarcf <- paste0("sarc", 1:5)

# Paletas
col_dominios <- c("#1F77B4", "#D62728", "#2CA02C", "#9467BD", "#FF7F0E", "#8C564B")
col_sarc     <- c("Sin Sarcopenia" = "steelblue", "Con Sarcopenia" = "firebrick")
col_likert   <- c("Nada" = "#2166AC", "Un poco" = "#67A9CF",
                  "Bastante" = "#F4A582", "Mucho" = "#B2182B")

theme_set(theme_minimal(base_size = 12))
```
## 2. Importación de datos
La ruta es relativa a la carpeta del proyecto para que el documento renderice en cualquier equipo. El resumen inicial excluye `docum` (documento de identidad), porque este informe se publica como sitio web.
```{r}
#| label: importar
data <- read_excel("SPARC_data_labels.xlsx", .name_repair = "unique_quiet")

data_resumen <- select(data, -docum)
print(
  dfSummary(data_resumen, graph.magnif = 0.75, valid.col = FALSE),
  method = "render"
)
```
## 3. Recodificación
### SARC-F
Cada ítem del SARC-F se puntúa de 0 a 2: *Ninguna* = 0, *Alguna* o *1 a 3 caídas* = 1, y las categorías de mayor dificultad (*Mucha o incapaz*, *4 o más caídas*) = 2.
```{r}
#| label: recodificar-sarcf
data <- data %>%
  mutate(across(
    all_of(items_sarcf),
    ~ case_when(
      .x == "Ninguna"                     ~ 0,
      .x %in% c("Alguna", "1 a 3 caídas") ~ 1,
      !is.na(.x)                          ~ 2
    )
  ))
```
### SPARC
Los ítems SPARC (s2–s42) se convierten a una escala numérica de 0 a 3: *Nada* = 0, *Un poco* = 1, *Bastante* = 2, *Mucho* = 3.
```{r}
#| label: recodificar-sparc
data <- data %>%
  mutate(across(
    all_of(items_sparc),
    ~ case_match(.x, "Nada" ~ 0, "Un poco" ~ 1, "Bastante" ~ 2, "Mucho" ~ 3)
  ))
```
### Covariables
Las variables categóricas se convierten a factor y se fija su categoría de referencia para los modelos. `transpor` viene como texto y se pasa a número.
```{r}
#| label: recodificar-covariables
data <- data %>%
  mutate(
    dx_oms_ca = relevel(factor(dx_oms_ca), ref = "No oncologica"),
    educa     = relevel(factor(educa),     ref = "Ninguno"),
    genero    = relevel(factor(genero),    ref = "Masculino"),
    procede   = relevel(factor(procede),   ref = "Urbana"),
    transpor  = as.numeric(transpor)
  )
```
## 4. Variables derivadas
### Puntaje SARC-F y sarcopenia probable
`sarc_tot` es la suma de los 5 ítems (rango 0–10). `sarc_tot_cat` clasifica como *Con Sarcopenia* a los pacientes con `sarc_tot > 4`. Se crea como factor desde el inicio para que tablas, gráficos y modelos usen las mismas etiquetas.
```{r}
#| label: sarcopenia
data <- data %>%
  mutate(
    sarc_tot     = rowSums(across(all_of(items_sarcf)), na.rm = TRUE),
    sarc_tot_cat = factor(
      if_else(sarc_tot > 4, "Con Sarcopenia", "Sin Sarcopenia"),
      levels = c("Sin Sarcopenia", "Con Sarcopenia")
    )
  )

count(data, sarc_tot_cat)
```
### Puntajes SPARC por dominio
Para cada dominio se calcula:
- el **puntaje bruto** (`sparc_*`): suma de sus ítems;
- el **puntaje ponderado** (`sparc_*_p`): el bruto expresado como porcentaje de su máximo posible (0–100), para que los dominios sean comparables entre sí.
Los ítems faltantes (9 respuestas en toda la base) se tratan como 0.
```{r}
#| label: dominios-sparc
for (i in seq_len(nrow(dominios))) {
  bruto <- rowSums(data[dominios$items[[i]]], na.rm = TRUE)
  data[[dominios$var[i]]]   <- bruto
  data[[dominios$var_p[i]]] <- round(bruto / dominios$maximo[i] * 100, 1)
}

data %>%
  select(all_of(dominios$var_p)) %>%
  summary()
```
### Puntaje SPARC total
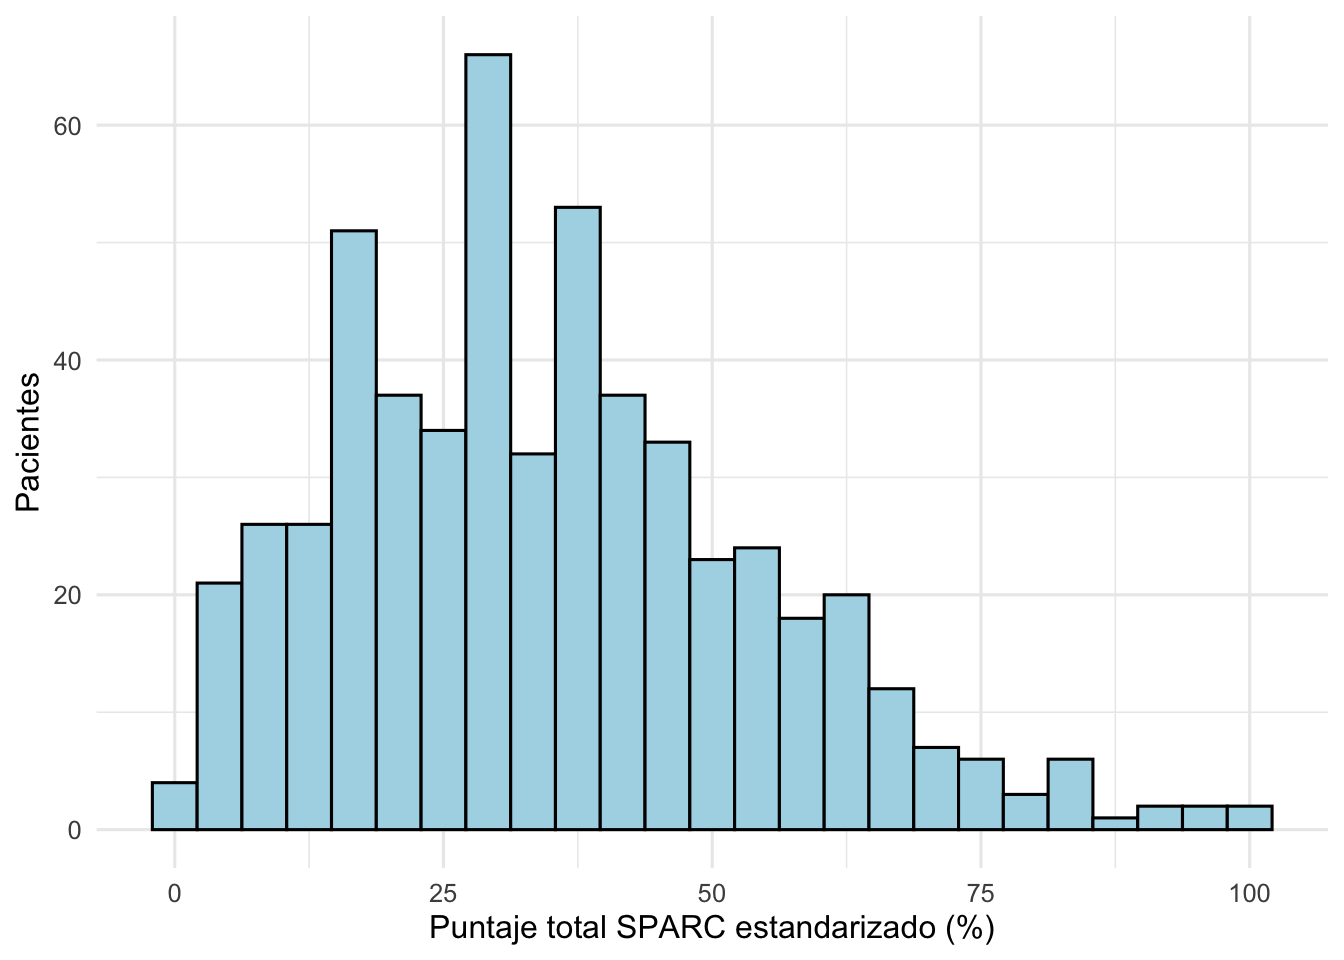
`sparc_total_p` es la suma de los 6 puntajes ponderados, de modo que cada dominio pesa lo mismo. `sparc_total_st` reescala ese total a 0–100 usando el mínimo y el máximo **observados** en la muestra. Este es el desenlace de los modelos de la sección 9.
```{r}
#| label: sparc-total
data <- data %>%
  mutate(
    sparc_total_p  = rowSums(across(all_of(dominios$var_p))),
    sparc_total_st = (sparc_total_p - min(sparc_total_p)) /
                     (max(sparc_total_p) - min(sparc_total_p)) * 100
  )

summary(data$sparc_total_st)
```
### Base en formato largo
`sparc_largo` tiene una fila por paciente y dominio ponderado. `items_largo` tiene una fila por paciente e ítem, con su respuesta Likert. Ambas se reutilizan en los gráficos y tablas siguientes.
```{r}
#| label: bases-largas
sparc_largo <- data %>%
  select(id, sarc_tot_cat, dx_oms_ca, all_of(dominios$var_p)) %>%
  pivot_longer(all_of(dominios$var_p), names_to = "dominio", values_to = "puntaje") %>%
  mutate(dominio = factor(dominio, levels = dominios$var_p, labels = dominios$nombre))

items_largo <- data %>%
  select(id, sarc_tot_cat, all_of(items_sparc)) %>%
  pivot_longer(all_of(items_sparc), names_to = "item", values_to = "valor") %>%
  filter(!is.na(valor)) %>%
  left_join(
    dominios %>% select(nombre, items) %>% unnest(items),
    by = c("item" = "items")
  ) %>%
  rename(dominio = nombre) %>%
  mutate(
    item      = factor(item, levels = items_sparc),
    valor     = factor(valor, levels = 0:3, labels = names(col_likert)),
    necesidad = factor(
      if_else(valor == "Nada", "Sin necesidades", "Presencia de necesidades"),
      levels = c("Sin necesidades", "Presencia de necesidades")
    )
  )
```
## 5. Exploración de los puntajes SPARC
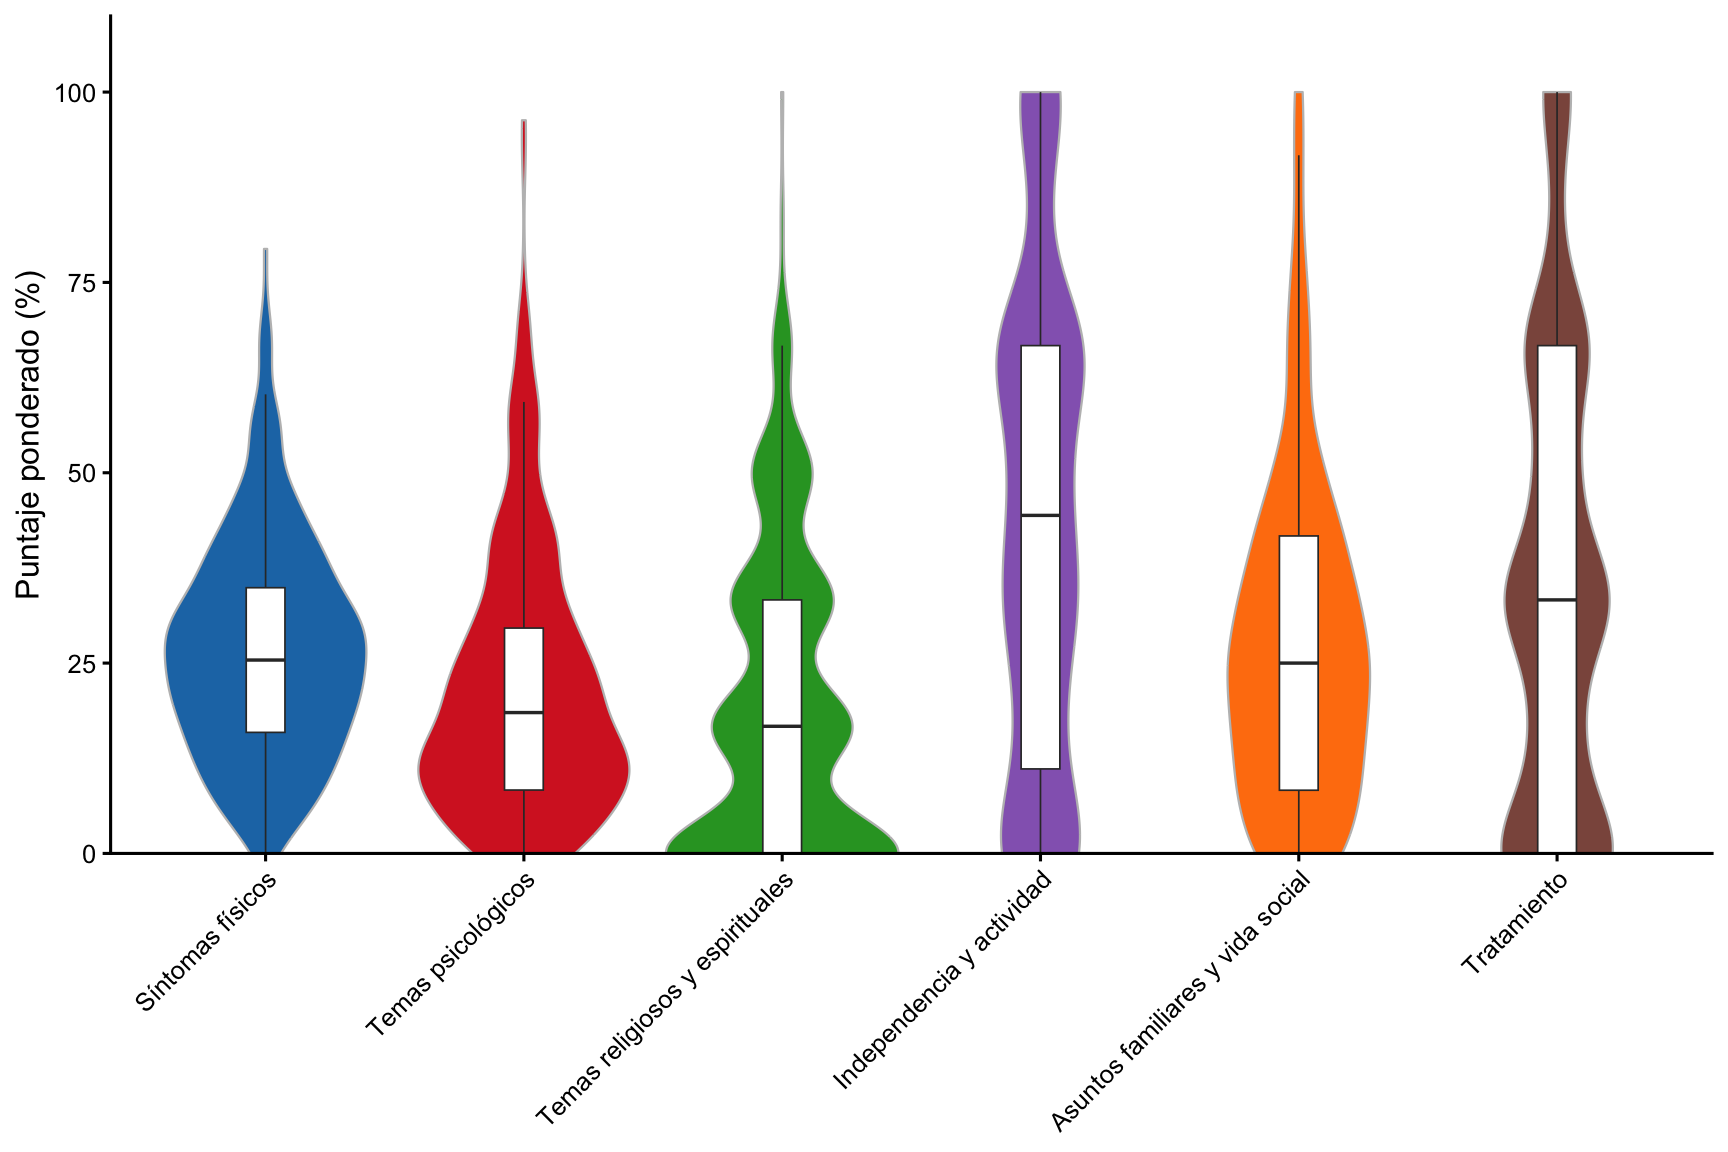
Distribución de los puntajes ponderados de cada dominio: violín (forma de la distribución) con boxplot superpuesto (mediana y RIC).
```{r}
#| label: fig-violin-dominios
#| fig-width: 9
#| fig-height: 6
ggplot(sparc_largo, aes(x = dominio, y = puntaje, fill = dominio)) +
  geom_violin(trim = TRUE, color = "grey", linewidth = 0.4) +
  geom_boxplot(width = 0.15, fill = "white", outlier.shape = NA, linewidth = 0.3) +
  scale_fill_manual(values = col_dominios) +
  scale_y_continuous(limits = c(0, NA), expand = expansion(mult = c(0, 0.1))) +
  labs(x = NULL, y = "Puntaje ponderado (%)") +
  theme_classic(base_size = 12) +
  theme(legend.position = "none", axis.text.x = element_text(angle = 45, hjust = 1))
```
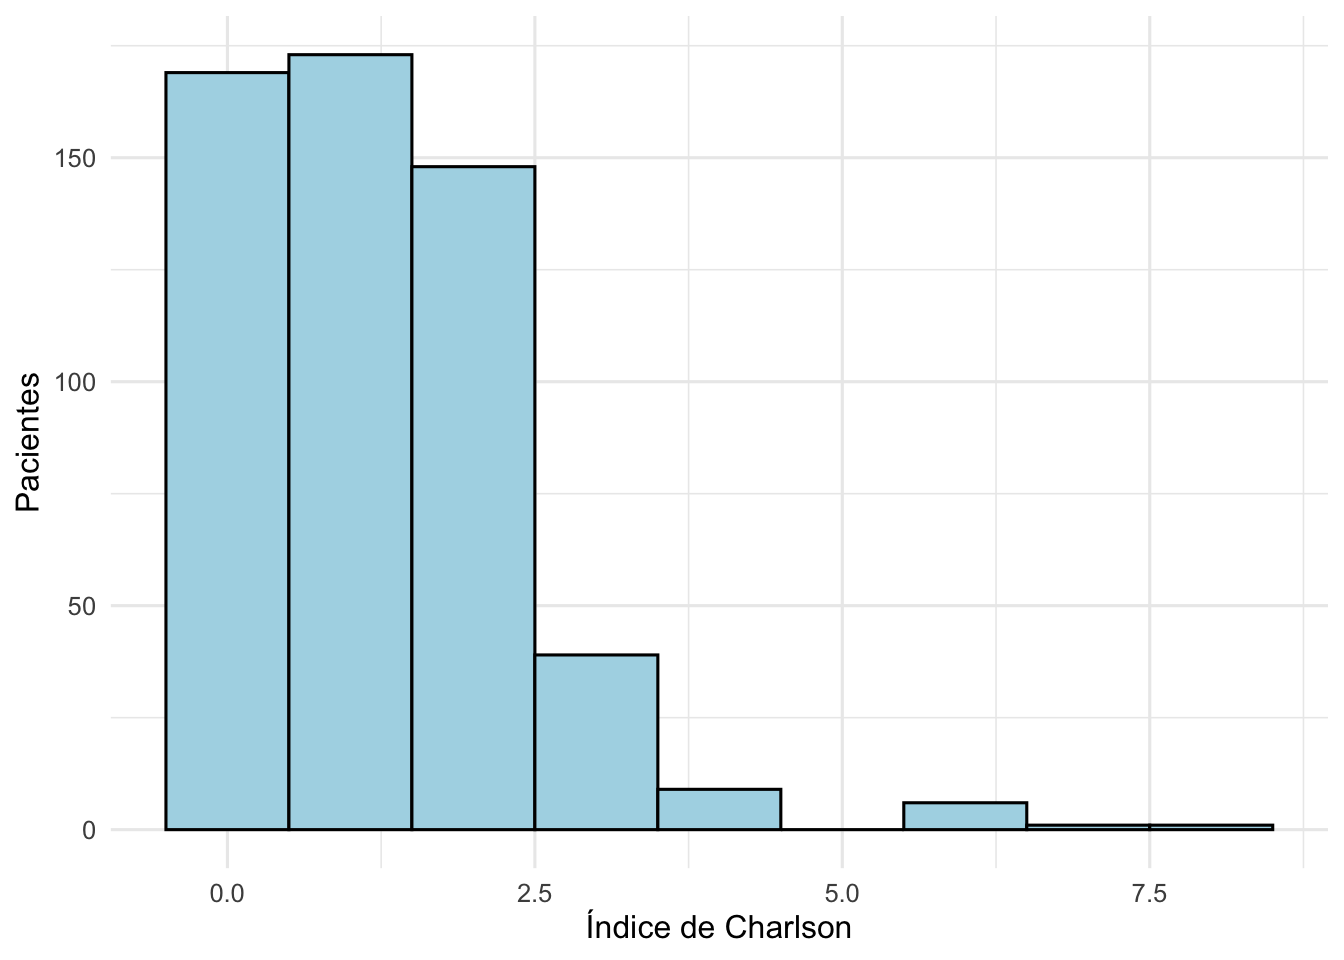
Comorbilidad: distribución del índice de Charlson.
```{r}
#| label: fig-charlson
summary(data$charlson)
ggplot(data, aes(x = charlson)) +
  geom_histogram(binwidth = 1, fill = "lightblue", color = "black") +
  labs(x = "Índice de Charlson", y = "Pacientes")
```
## 6. Objetivo 1 — Características sociodemográficas
Tabla 1, por grupo de sarcopenia. Las variables continuas se resumen con mediana (p25, p75).
```{r}
#| label: tabla-1
data %>%
  tbl_summary(
    include   = c(genero, etnia, edad, charlson, dx_oms_ca, civil, religion,
                  educa, procede, convivi, transpor),
    by        = sarc_tot_cat,
    type      = list(charlson ~ "continuous"),
    statistic = list(all_continuous() ~ "{median} ({p25}, {p75})"),
    missing   = "no",
    sort      = all_categorical() ~ "frequency"
  ) %>%
  add_n() %>%
  add_overall()
```
## 7. Objetivo 2 — Prevalencia de sarcopenia
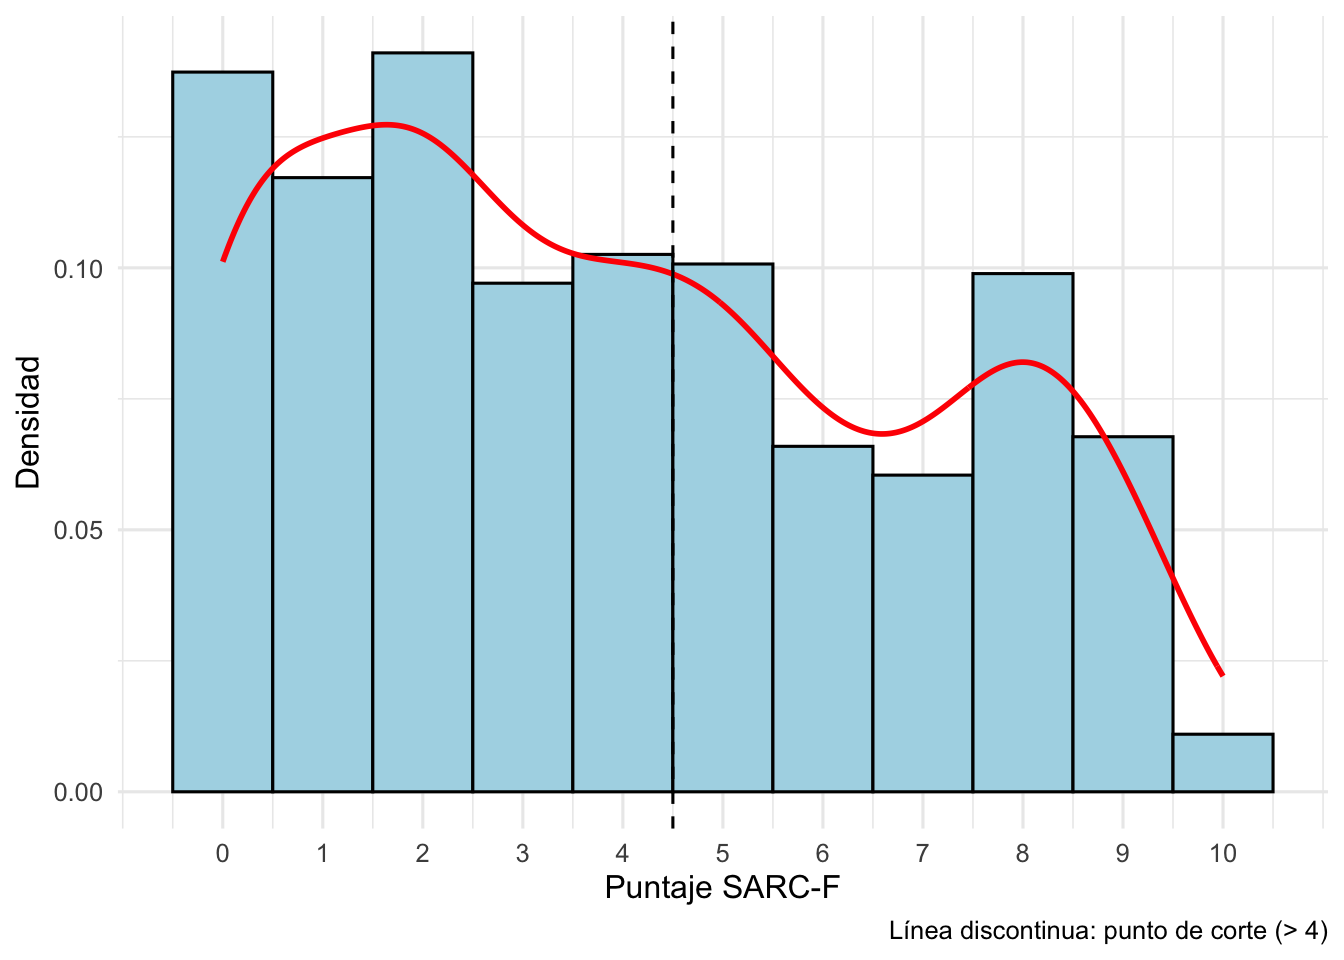
### Distribución del puntaje SARC-F
```{r}
#| label: fig-sarcf
ggplot(data, aes(x = sarc_tot)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 1,
                 fill = "lightblue", color = "black") +
  geom_density(color = "red", linewidth = 1) +
  geom_vline(xintercept = 4.5, linetype = "dashed") +
  scale_x_continuous(breaks = 0:10) +
  labs(x = "Puntaje SARC-F", y = "Densidad",
       caption = "Línea discontinua: punto de corte (> 4)")
```
### Prevalencia global (IC95% de Wilson)
```{r}
#| label: prevalencia-sarcopenia
data %>%
  tbl_summary(
    include   = sarc_tot_cat,
    missing   = "no",
    statistic = all_categorical() ~ "{n} ({p}%)"
  ) %>%
  add_ci(
    method  = list(all_categorical() ~ "wilson"),
    pattern = "{stat} (IC95%: {ci})"
  )
```
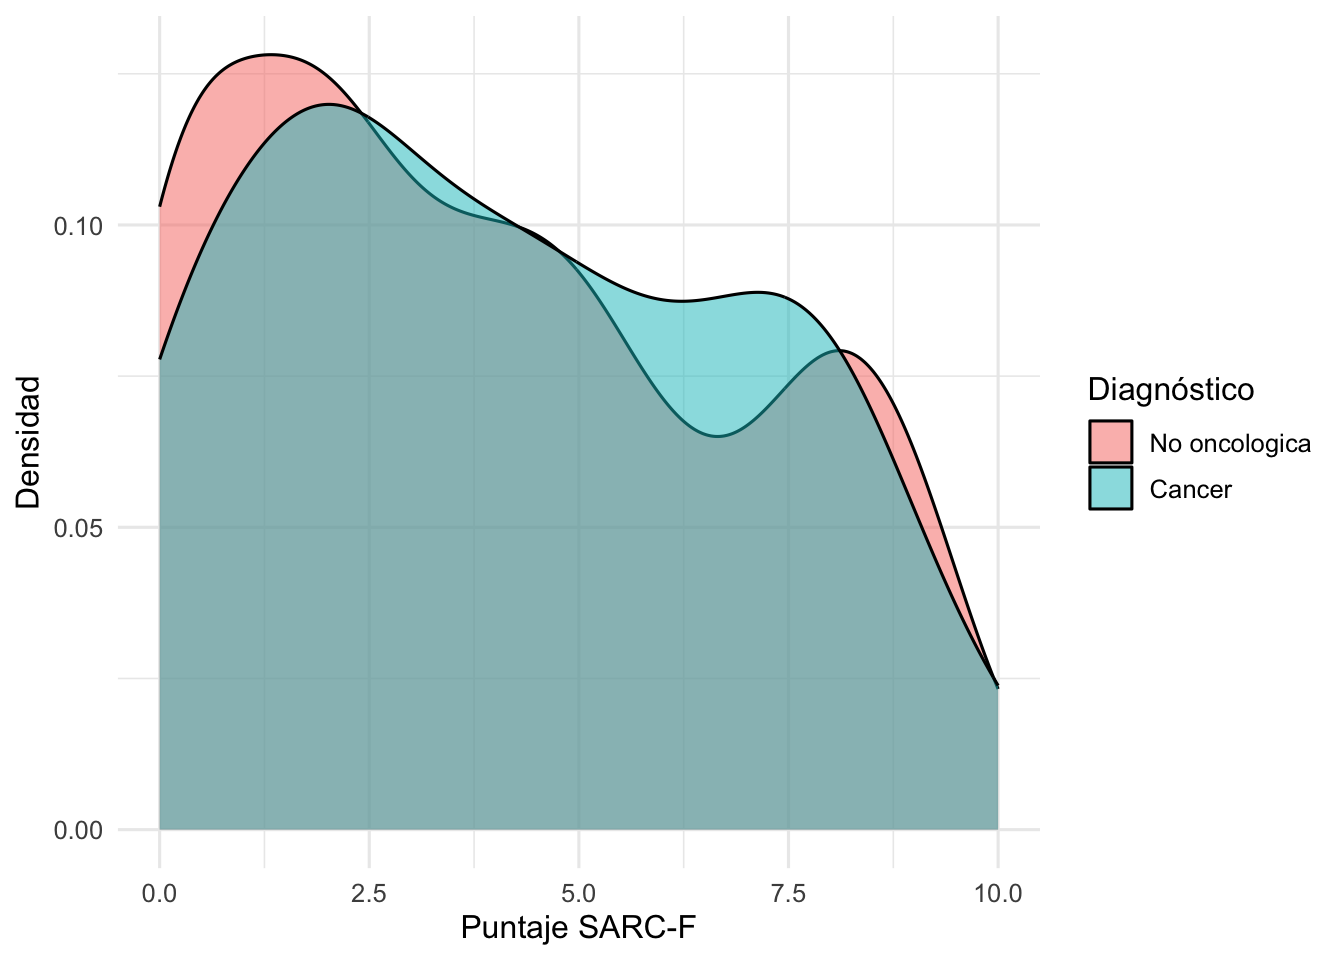
### Prevalencia según tipo de diagnóstico
```{r}
#| label: prevalencia-por-dx
data %>%
  tbl_summary(
    include   = c(sarc_tot, sarc_tot_cat),
    by        = dx_oms_ca,
    type      = list(sarc_tot ~ "continuous"),
    statistic = list(all_continuous() ~ "{median} ({p25}, {p75})",
                     all_categorical() ~ "{n} ({p}%)"),
    missing   = "no"
  ) %>%
  add_ci(method = list(all_categorical() ~ "wilson")) %>%
  add_n() %>%
  add_overall()
```
```{r}
#| label: fig-sarcf-por-dx
ggplot(data, aes(x = sarc_tot, fill = dx_oms_ca)) +
  geom_density(alpha = 0.5) +
  labs(x = "Puntaje SARC-F", y = "Densidad", fill = "Diagnóstico")
```
## 8. Objetivo 3 — Necesidades no satisfechas (SPARC)
### Distribución de respuestas por ítem
Para cada ítem: n (%) de pacientes en cada nivel de respuesta.
```{r}
#| label: tabla-items
items_largo %>%
  count(item, valor, .drop = FALSE) %>%
  group_by(item) %>%
  mutate(stat = paste0(n, " (", round(100 * n / sum(n), 1), "%)")) %>%
  ungroup() %>%
  select(-n) %>%
  pivot_wider(names_from = valor, values_from = stat) %>%
  gt() %>%
  cols_label(item = "Ítem")
```
### Prevalencia de necesidades por paciente
Un paciente tiene una necesidad en un dominio si responde algo distinto de *Nada* en al menos un ítem de ese dominio. Esta es la prevalencia que responde al objetivo 3: la unidad de análisis es el paciente.
```{r}
#| label: prevalencia-paciente
necesidades_paciente <- data %>%
  transmute(
    sarc_tot_cat,
    cualquier = rowSums(across(all_of(items_sparc)), na.rm = TRUE) > 0,
    across(all_of(dominios$var), ~ .x > 0)
  )

necesidades_paciente %>%
  tbl_summary(
    include = -sarc_tot_cat,
    label   = c(
      list(cualquier ~ "Cualquier dominio"),
      map2(dominios$var, dominios$nombre, ~ as.formula(paste0(.x, " ~ '", .y, "'")))
    ),
    statistic = all_categorical() ~ "{n} ({p}%)",
    missing   = "no"
  ) %>%
  add_ci(method = list(all_categorical() ~ "wilson")) %>%
  modify_header(label = "**Pacientes con al menos una necesidad**")
```
### Proporción de respuestas con necesidad (ítem × paciente)
Esta tabla usa como unidad **cada respuesta** (546 pacientes × 41 ítems). Indica qué fracción de todas las respuestas reporta alguna necesidad; no es una prevalencia por paciente.
```{r}
#| label: tabla-global-respuestas
ic <- binom.confint(
  x      = sum(items_largo$necesidad == "Presencia de necesidades"),
  n      = nrow(items_largo),
  method = "wilson"
)

items_largo %>%
  count(necesidad) %>%
  mutate(
    `n (%)` = paste0(n, " (", round(100 * n / sum(n), 1), "%)"),
    IC95    = if_else(
      necesidad == "Presencia de necesidades",
      paste0(round(ic$lower * 100, 1), "–", round(ic$upper * 100, 1), "%"),
      ""
    )
  ) %>%
  select(Estado = necesidad, `n (%)`, IC95) %>%
  gt()
```
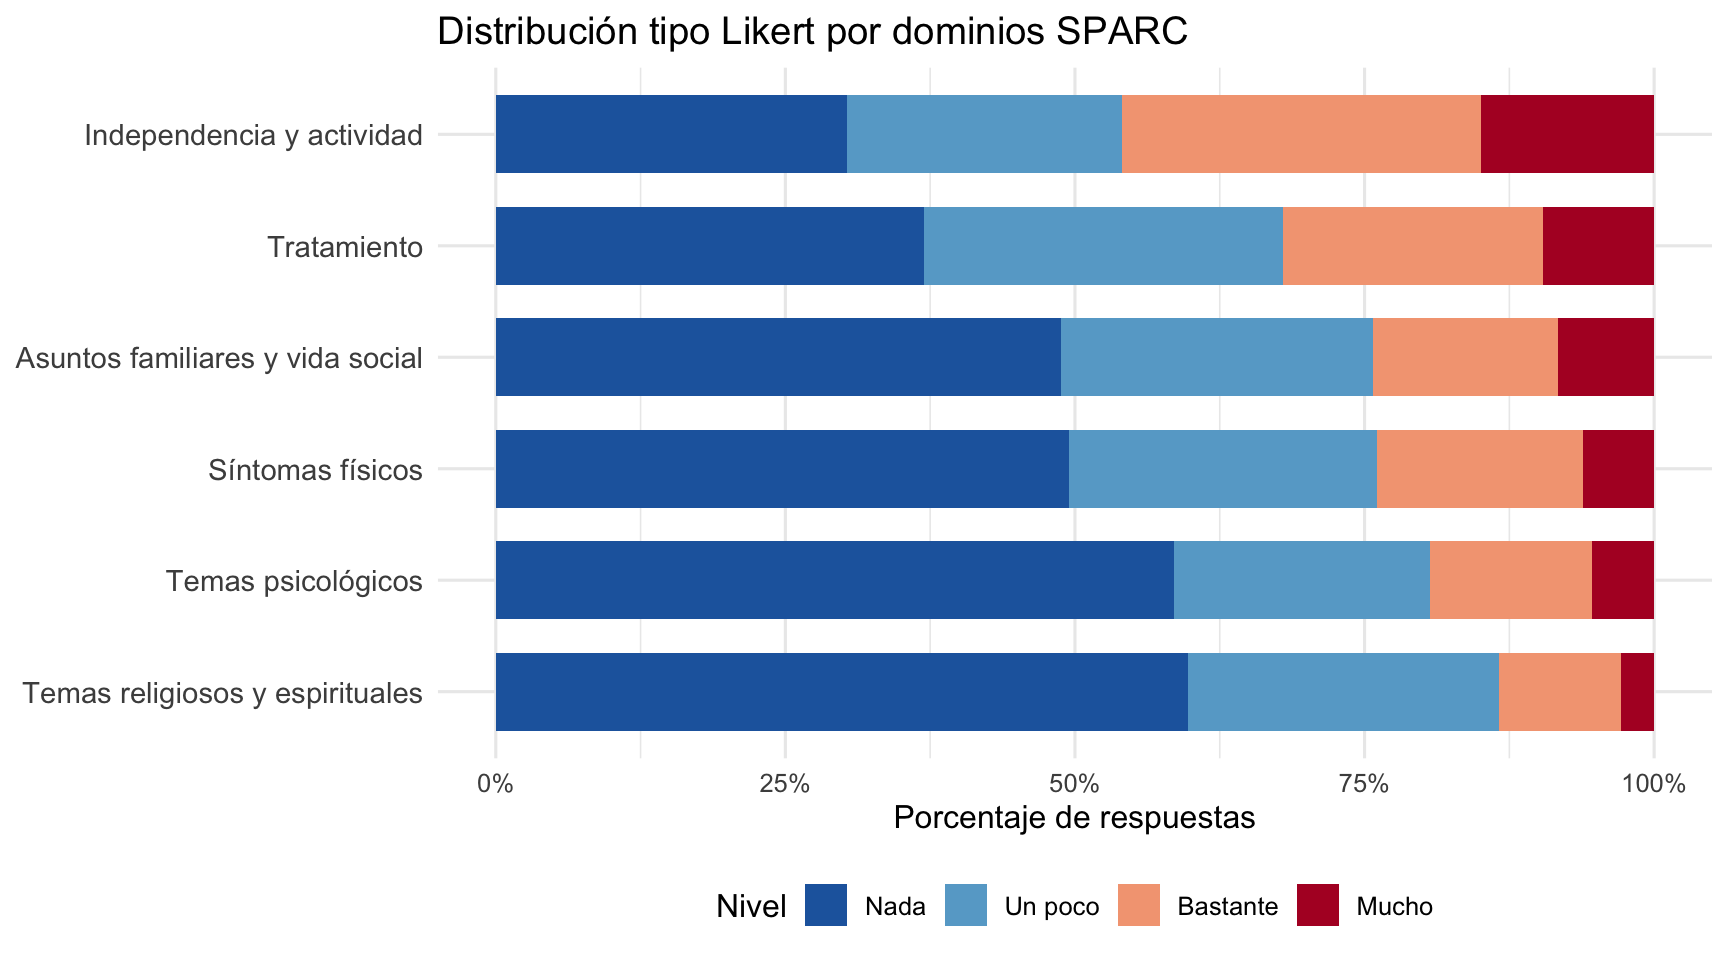
### Distribución tipo Likert por dominio
Los dominios se ordenan de mayor a menor proporción de respuestas *Nada*.
```{r}
#| label: datos-likert
likert_dominio <- items_largo %>%
  count(dominio, valor) %>%
  group_by(dominio) %>%
  mutate(
    prop      = n / sum(n),
    prop_nada = sum(prop[valor == "Nada"])
  ) %>%
  ungroup() %>%
  mutate(dominio = fct_reorder(dominio, prop_nada, .desc = TRUE))
```
Todas las categorías de respuesta:
```{r}
#| label: fig-likert-completo
#| fig-width: 9
ggplot(likert_dominio, aes(x = dominio, y = prop, fill = valor)) +
  geom_col(position = position_fill(reverse = TRUE), width = 0.7) +
  coord_flip() +
  scale_y_continuous(labels = scales::percent) +
  scale_fill_manual(values = col_likert) +
  labs(x = NULL, y = "Porcentaje de respuestas", fill = "Nivel",
       title = "Distribución tipo Likert por dominios SPARC") +
  theme(axis.text.y = element_text(size = 11), legend.position = "bottom")
```
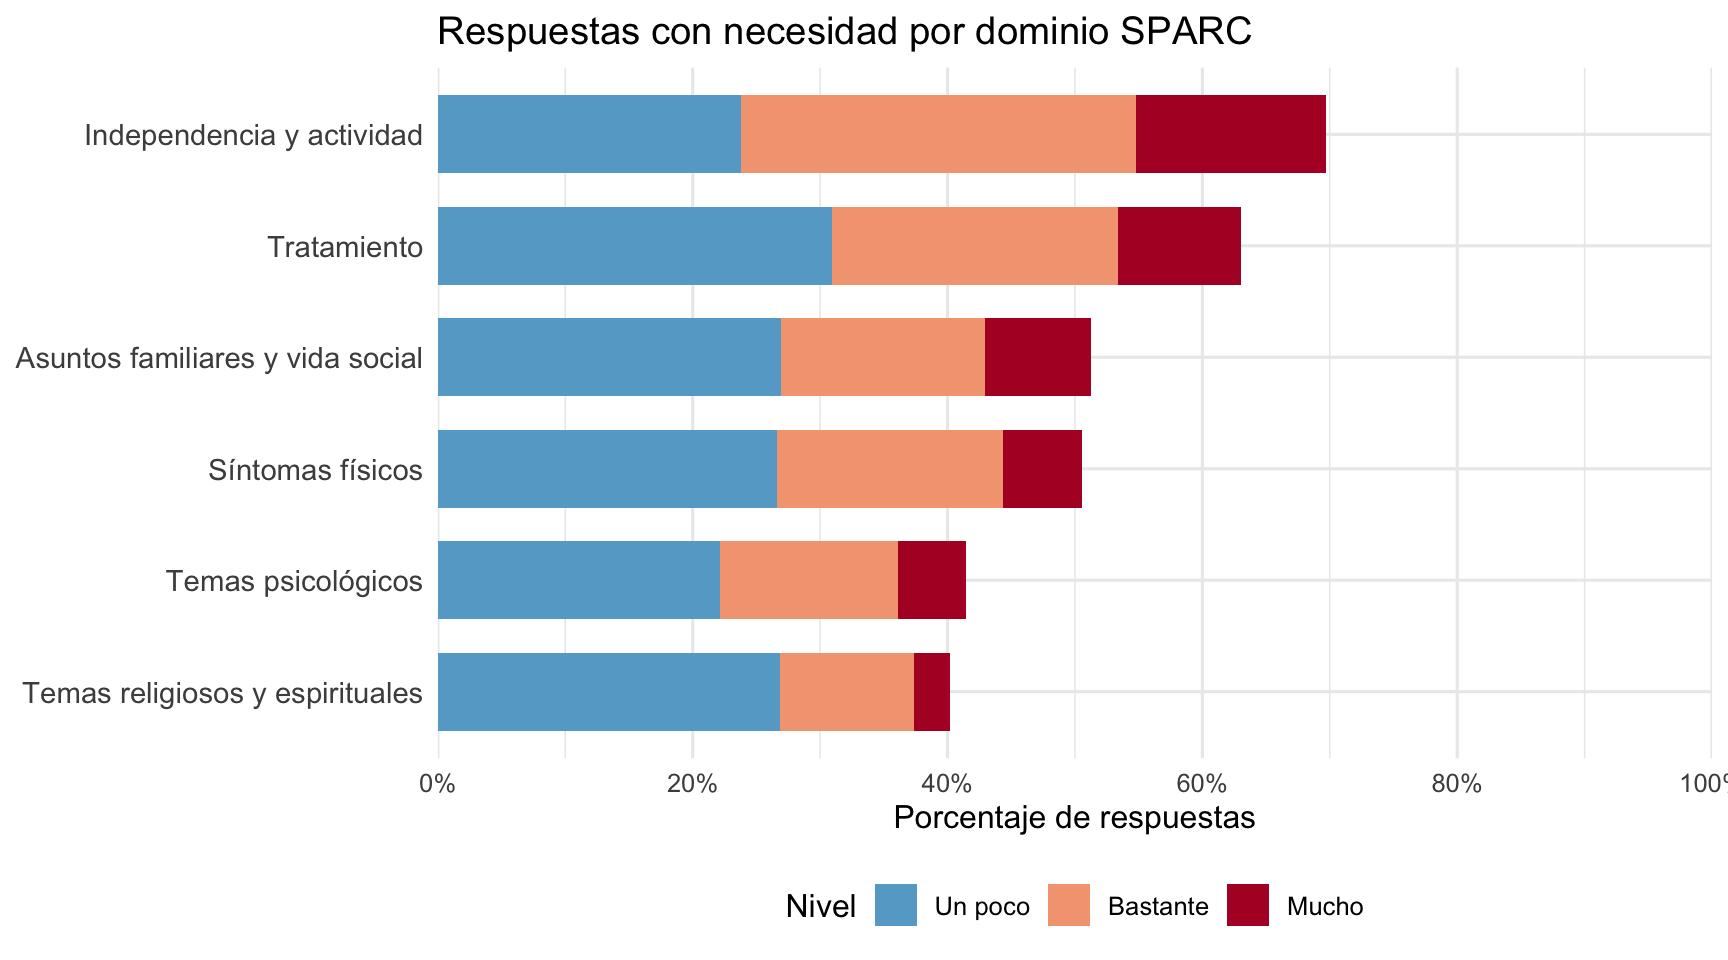
Solo las respuestas con necesidad (*Un poco*, *Bastante*, *Mucho*). La longitud de cada barra es la proporción de respuestas con alguna necesidad:
```{r}
#| label: fig-likert-necesidades
#| fig-width: 9
ggplot(
  filter(likert_dominio, valor != "Nada"),
  aes(x = dominio, y = prop, fill = valor)
) +
  geom_col(position = position_stack(reverse = TRUE), width = 0.7) +
  coord_flip() +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2),
                     labels = scales::percent, expand = c(0, 0)) +
  scale_fill_manual(values = col_likert[-1]) +
  labs(x = NULL, y = "Porcentaje de respuestas", fill = "Nivel",
       title = "Respuestas con necesidad por dominio SPARC") +
  theme(axis.text.y = element_text(size = 11), legend.position = "bottom")
```
### Tablas por dominio (unidad: respuesta)
```{r}
#| label: tablas-por-dominio
items_largo %>%
  tbl_summary(
    by        = dominio,
    include   = valor,
    statistic = all_categorical() ~ "{p}%",
    missing   = "no"
  ) %>%
  modify_header(label = "**Nivel**") %>%
  bold_labels()
items_largo %>%
  tbl_summary(
    by        = dominio,
    include   = necesidad,
    statistic = all_categorical() ~ "{n} ({p}%)",
    missing   = "no"
  ) %>%
  modify_header(label = "**Estado**") %>%
  bold_labels()
```
## 9. Objetivo 3.1 — Necesidades según sarcopenia
### Puntajes por dominio según diagnóstico y sarcopenia
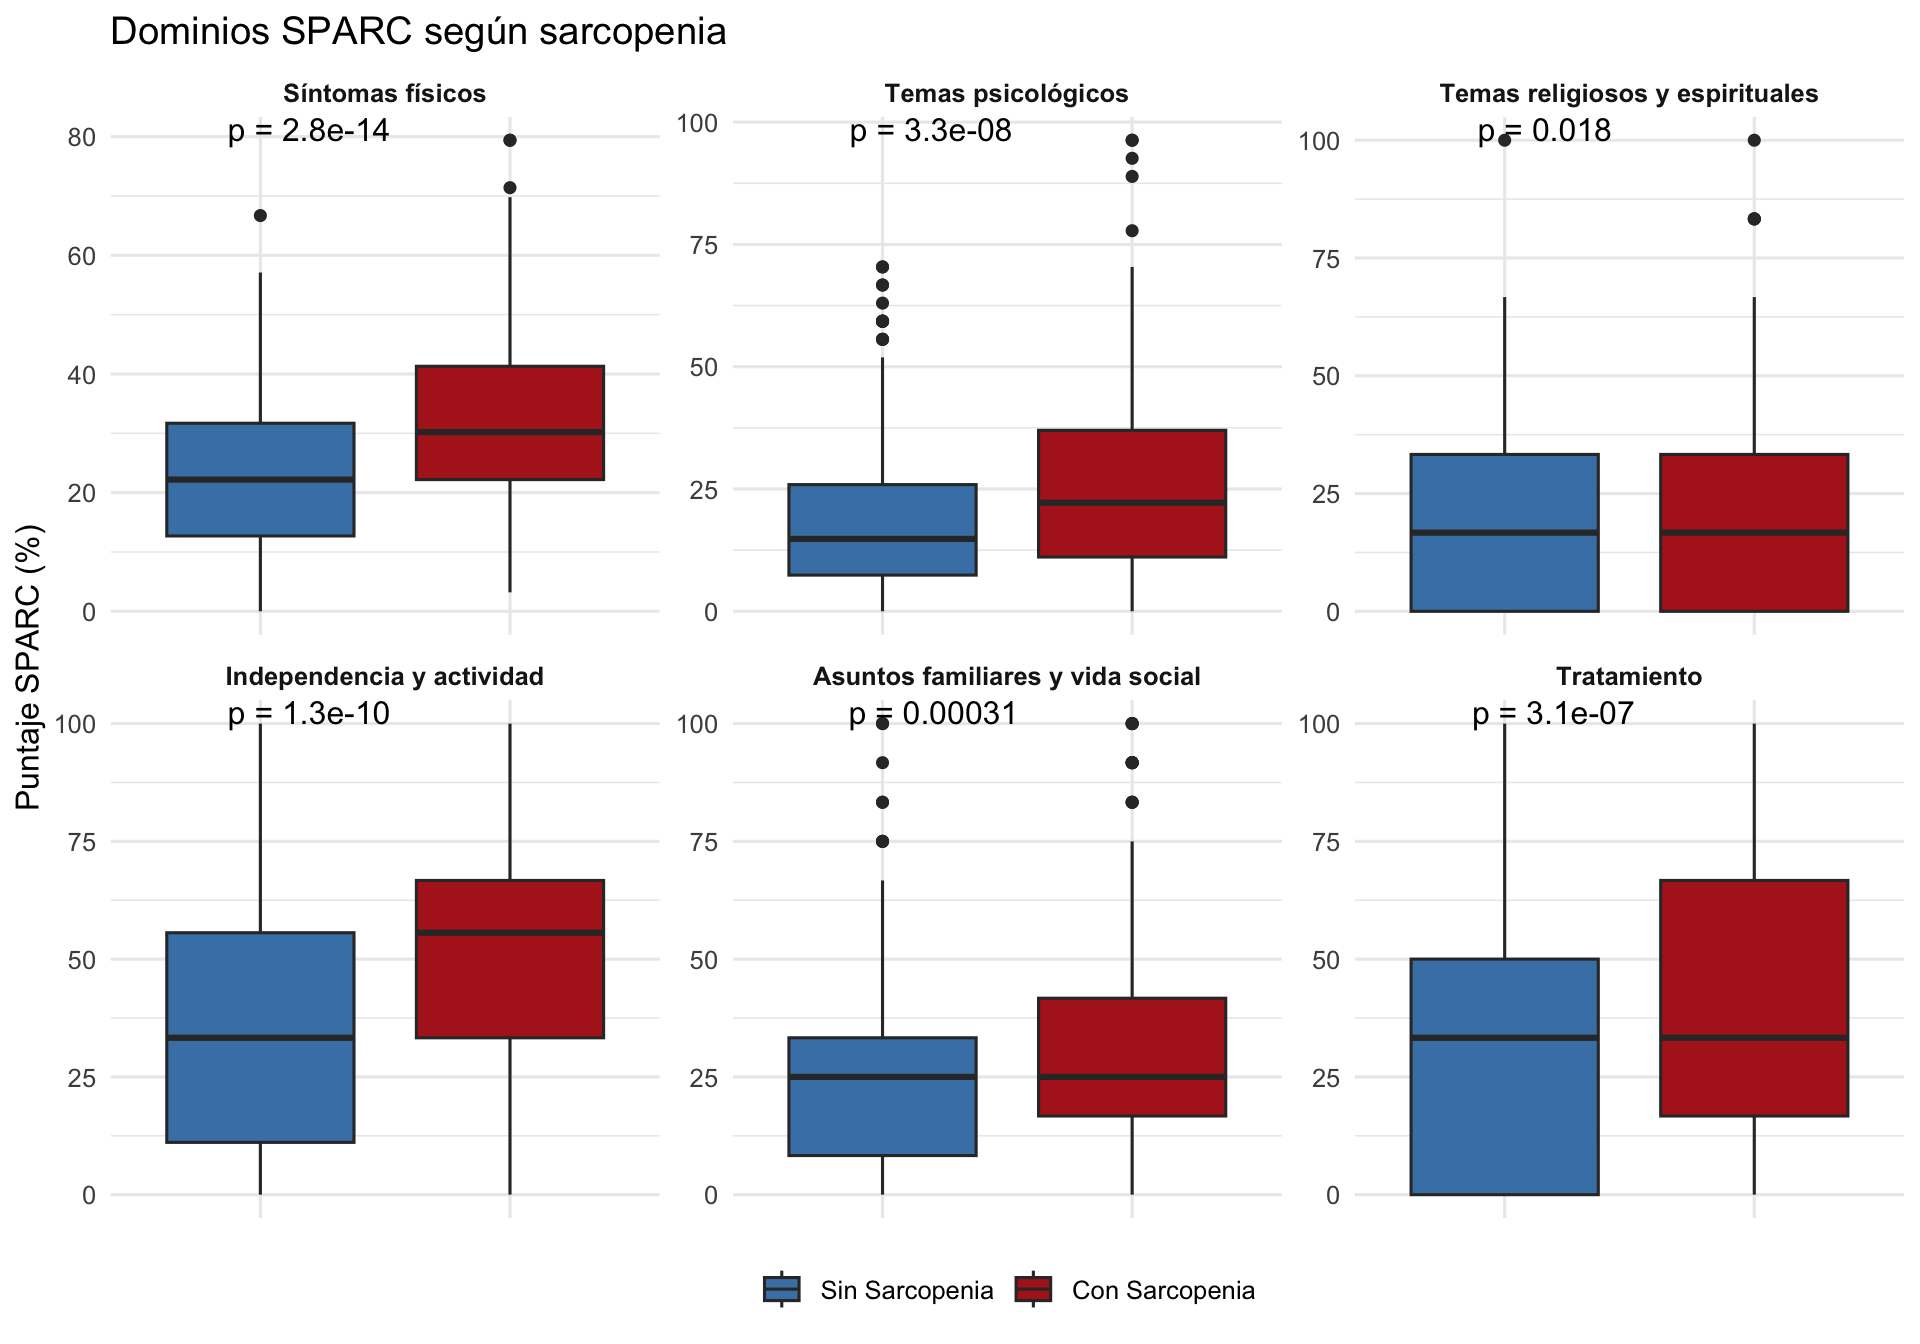
Medianas (p25, p75). Los valores p corresponden a la prueba de Wilcoxon (Mann-Whitney).
```{r}
#| label: dominios-por-grupo
tabla_dominios_por <- function(grupo) {
  data %>%
    tbl_summary(
      include   = all_of(dominios$var_p),
      by        = {{ grupo }},
      label     = as.list(etiquetas_dominio),
      type      = all_of(dominios$var_p) ~ "continuous",
      statistic = all_continuous() ~ "{median} ({p25}, {p75})",
      missing   = "no"
    ) %>%
    add_n() %>%
    add_p() %>%
    add_overall()
}

tabla_dominios_por(dx_oms_ca)
tabla_dominios_por(sarc_tot_cat)
```
```{r}
#| label: fig-dominios-sarcopenia
#| fig-width: 10
#| fig-height: 7
ggplot(sparc_largo, aes(x = sarc_tot_cat, y = puntaje, fill = sarc_tot_cat)) +
  geom_boxplot() +
  facet_wrap(~ dominio, scales = "free_y") +
  stat_compare_means(method = "wilcox.test", label = "p.format") +
  scale_fill_manual(values = col_sarc) +
  labs(x = NULL, y = "Puntaje SPARC (%)", fill = NULL,
       title = "Dominios SPARC según sarcopenia") +
  theme(legend.position = "bottom", strip.text = element_text(face = "bold"),
        axis.text.x = element_blank())
```
### Normalidad de los puntajes
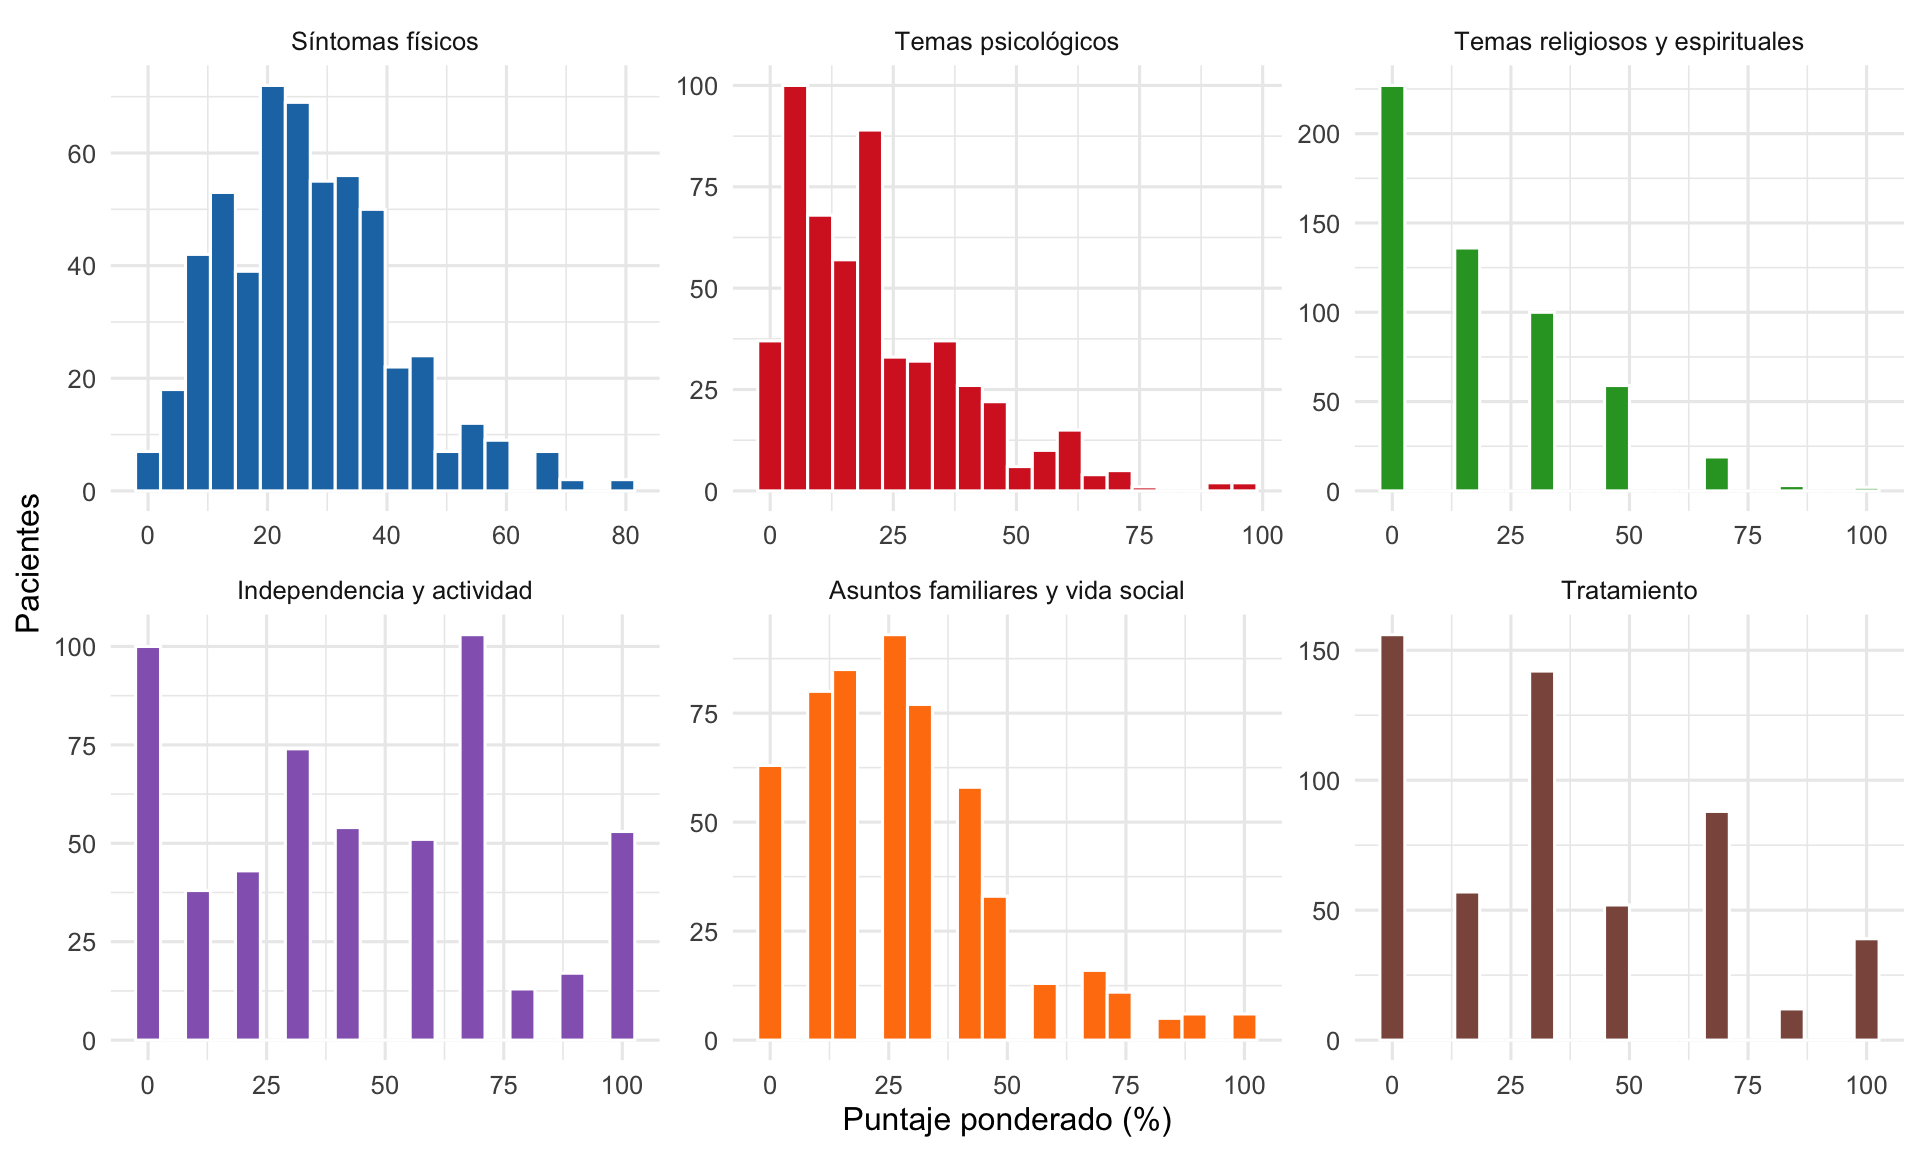
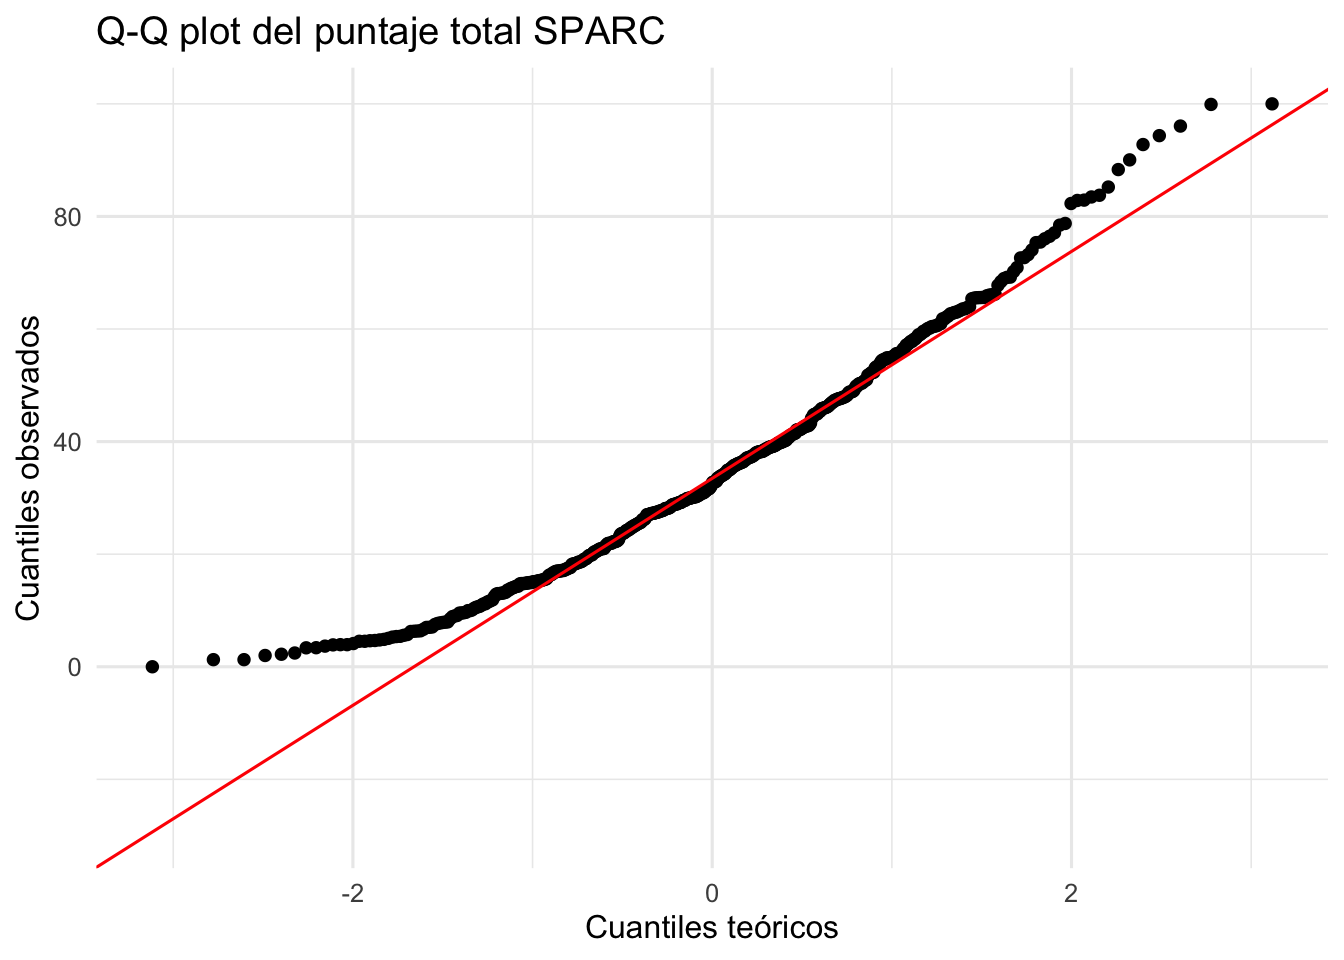
Con n = 546, la prueba de Shapiro-Wilk detecta desviaciones mínimas de la normalidad. Conviene interpretarla junto con los histogramas.
```{r}
#| label: fig-normalidad-dominios
#| fig-width: 10
#| fig-height: 6
ggplot(sparc_largo, aes(x = puntaje, fill = dominio)) +
  geom_histogram(bins = 20, color = "white") +
  facet_wrap(~ dominio, scales = "free") +
  scale_fill_manual(values = col_dominios) +
  labs(x = "Puntaje ponderado (%)", y = "Pacientes") +
  theme(legend.position = "none")

sparc_largo %>%
  group_by(dominio) %>%
  summarise(
    W = shapiro.test(puntaje)$statistic,
    p = shapiro.test(puntaje)$p.value
  ) %>%
  gt() %>%
  fmt_number(W, decimals = 3) %>%
  fmt_scientific(p, decimals = 2)
```
### Puntaje SPARC total
```{r}
#| label: fig-total
#| layout-ncol: 2
ggplot(data, aes(x = sparc_total_st)) +
  geom_histogram(bins = 25, fill = "lightblue", color = "black") +
  labs(x = "Puntaje total SPARC estandarizado (%)", y = "Pacientes")

ggplot(data, aes(sample = sparc_total_st)) +
  stat_qq() +
  stat_qq_line(color = "red") +
  labs(title = "Q-Q plot del puntaje total SPARC",
       x = "Cuantiles teóricos", y = "Cuantiles observados")

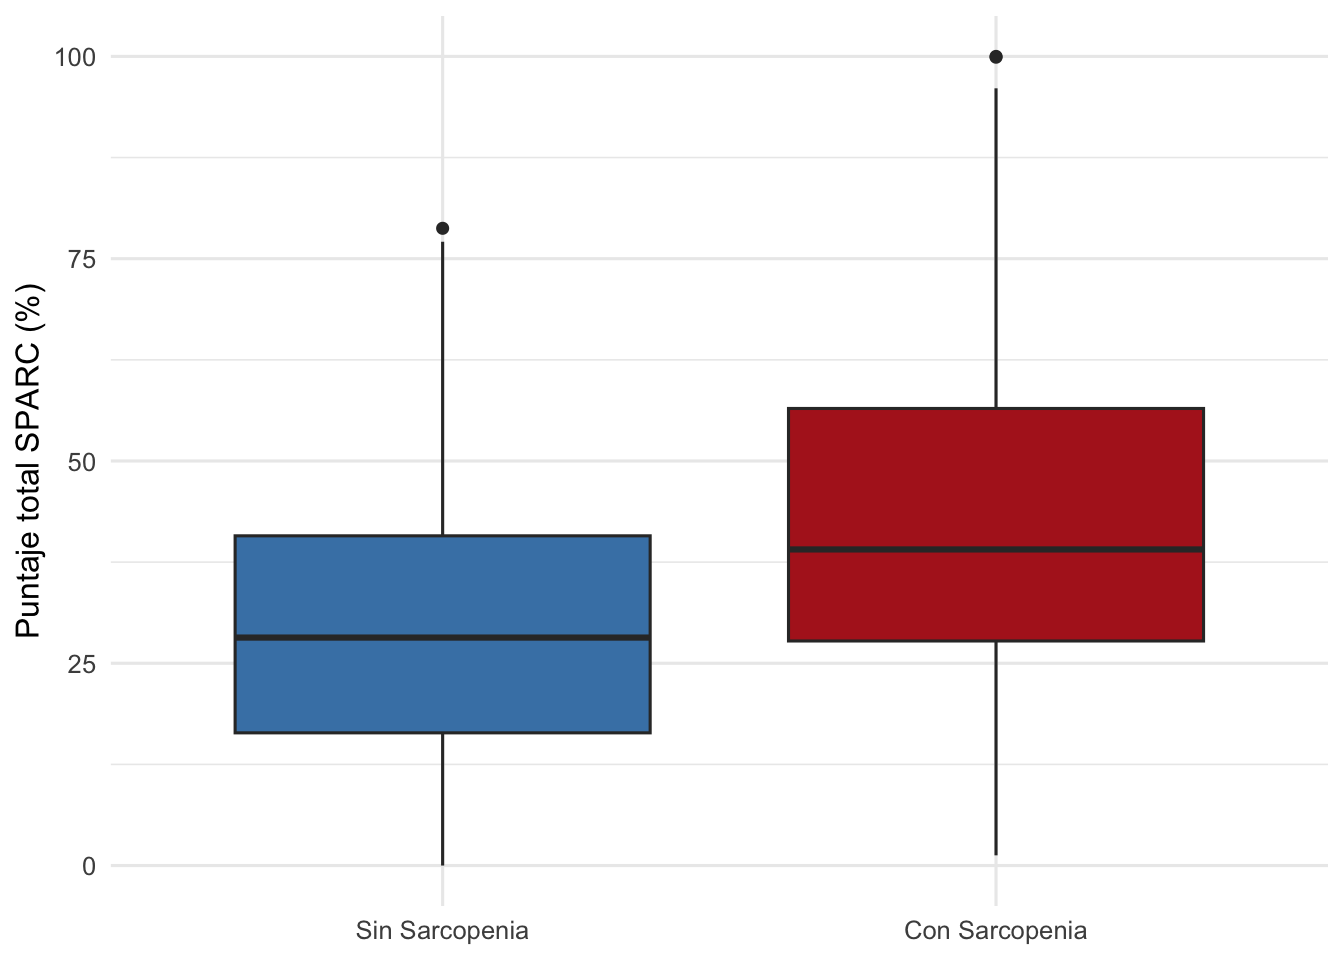
ggplot(data, aes(x = sarc_tot_cat, y = sparc_total_st, fill = sarc_tot_cat)) +
  geom_boxplot() +
  scale_fill_manual(values = col_sarc) +
  labs(x = NULL, y = "Puntaje total SPARC (%)") +
  theme(legend.position = "none")

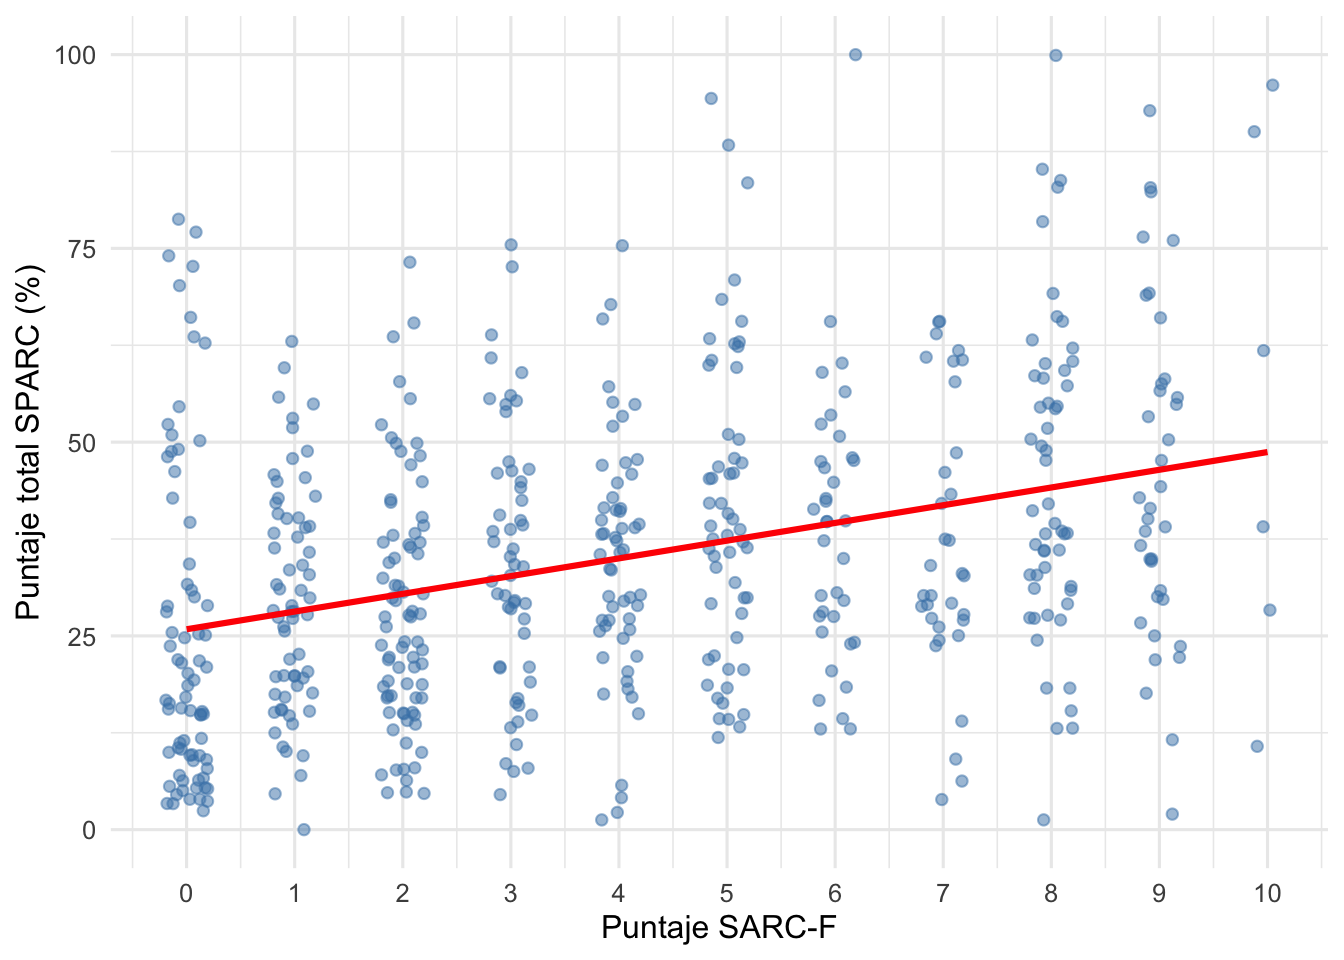
ggplot(data, aes(x = sarc_tot, y = sparc_total_st)) +
  geom_jitter(alpha = 0.5, width = 0.2, color = "steelblue") +
  geom_smooth(method = "lm", color = "red", se = FALSE) +
  scale_x_continuous(breaks = 0:10) +
  labs(x = "Puntaje SARC-F", y = "Puntaje total SPARC (%)")
```
## 10. Modelos de regresión lineal
### Modelo 1: crudo (puntaje SPARC total)
El coeficiente de `sarc_tot_cat` estima la diferencia media en el puntaje SPARC total estandarizado entre pacientes con y sin sarcopenia.
```{r}
#| label: modelo-1
data %>%
  tbl_summary(
    include   = sparc_total_st,
    by        = sarc_tot_cat,
    type      = list(sparc_total_st ~ "continuous"),
    statistic = all_continuous() ~ "{median} ({p25}, {p75})",
    missing   = "no"
  ) %>%
  add_n() %>%
  add_p() %>%
  add_overall()
model1 <- lm(sparc_total_st ~ sarc_tot_cat, data = data)
tbl_regression(model1)
model_performance(model1)
```
```{r}
#| label: modelo-1-supuestos
#| fig-width: 10
#| fig-height: 9
check_model(model1)
```
### Modelo 2: ajustado (puntaje SPARC total)
Diferencias ajustadas por diagnóstico, edad, sexo, estado funcional (Karnofsky) y comorbilidad (Charlson).
```{r}
#| label: modelo-2
covariables <- "dx_oms_ca + edad + genero + karno + charlson"

model2 <- lm(as.formula(paste("sparc_total_st ~ sarc_tot_cat +", covariables)), data = data)
tbl_regression(model2)
model_performance(model2)
```
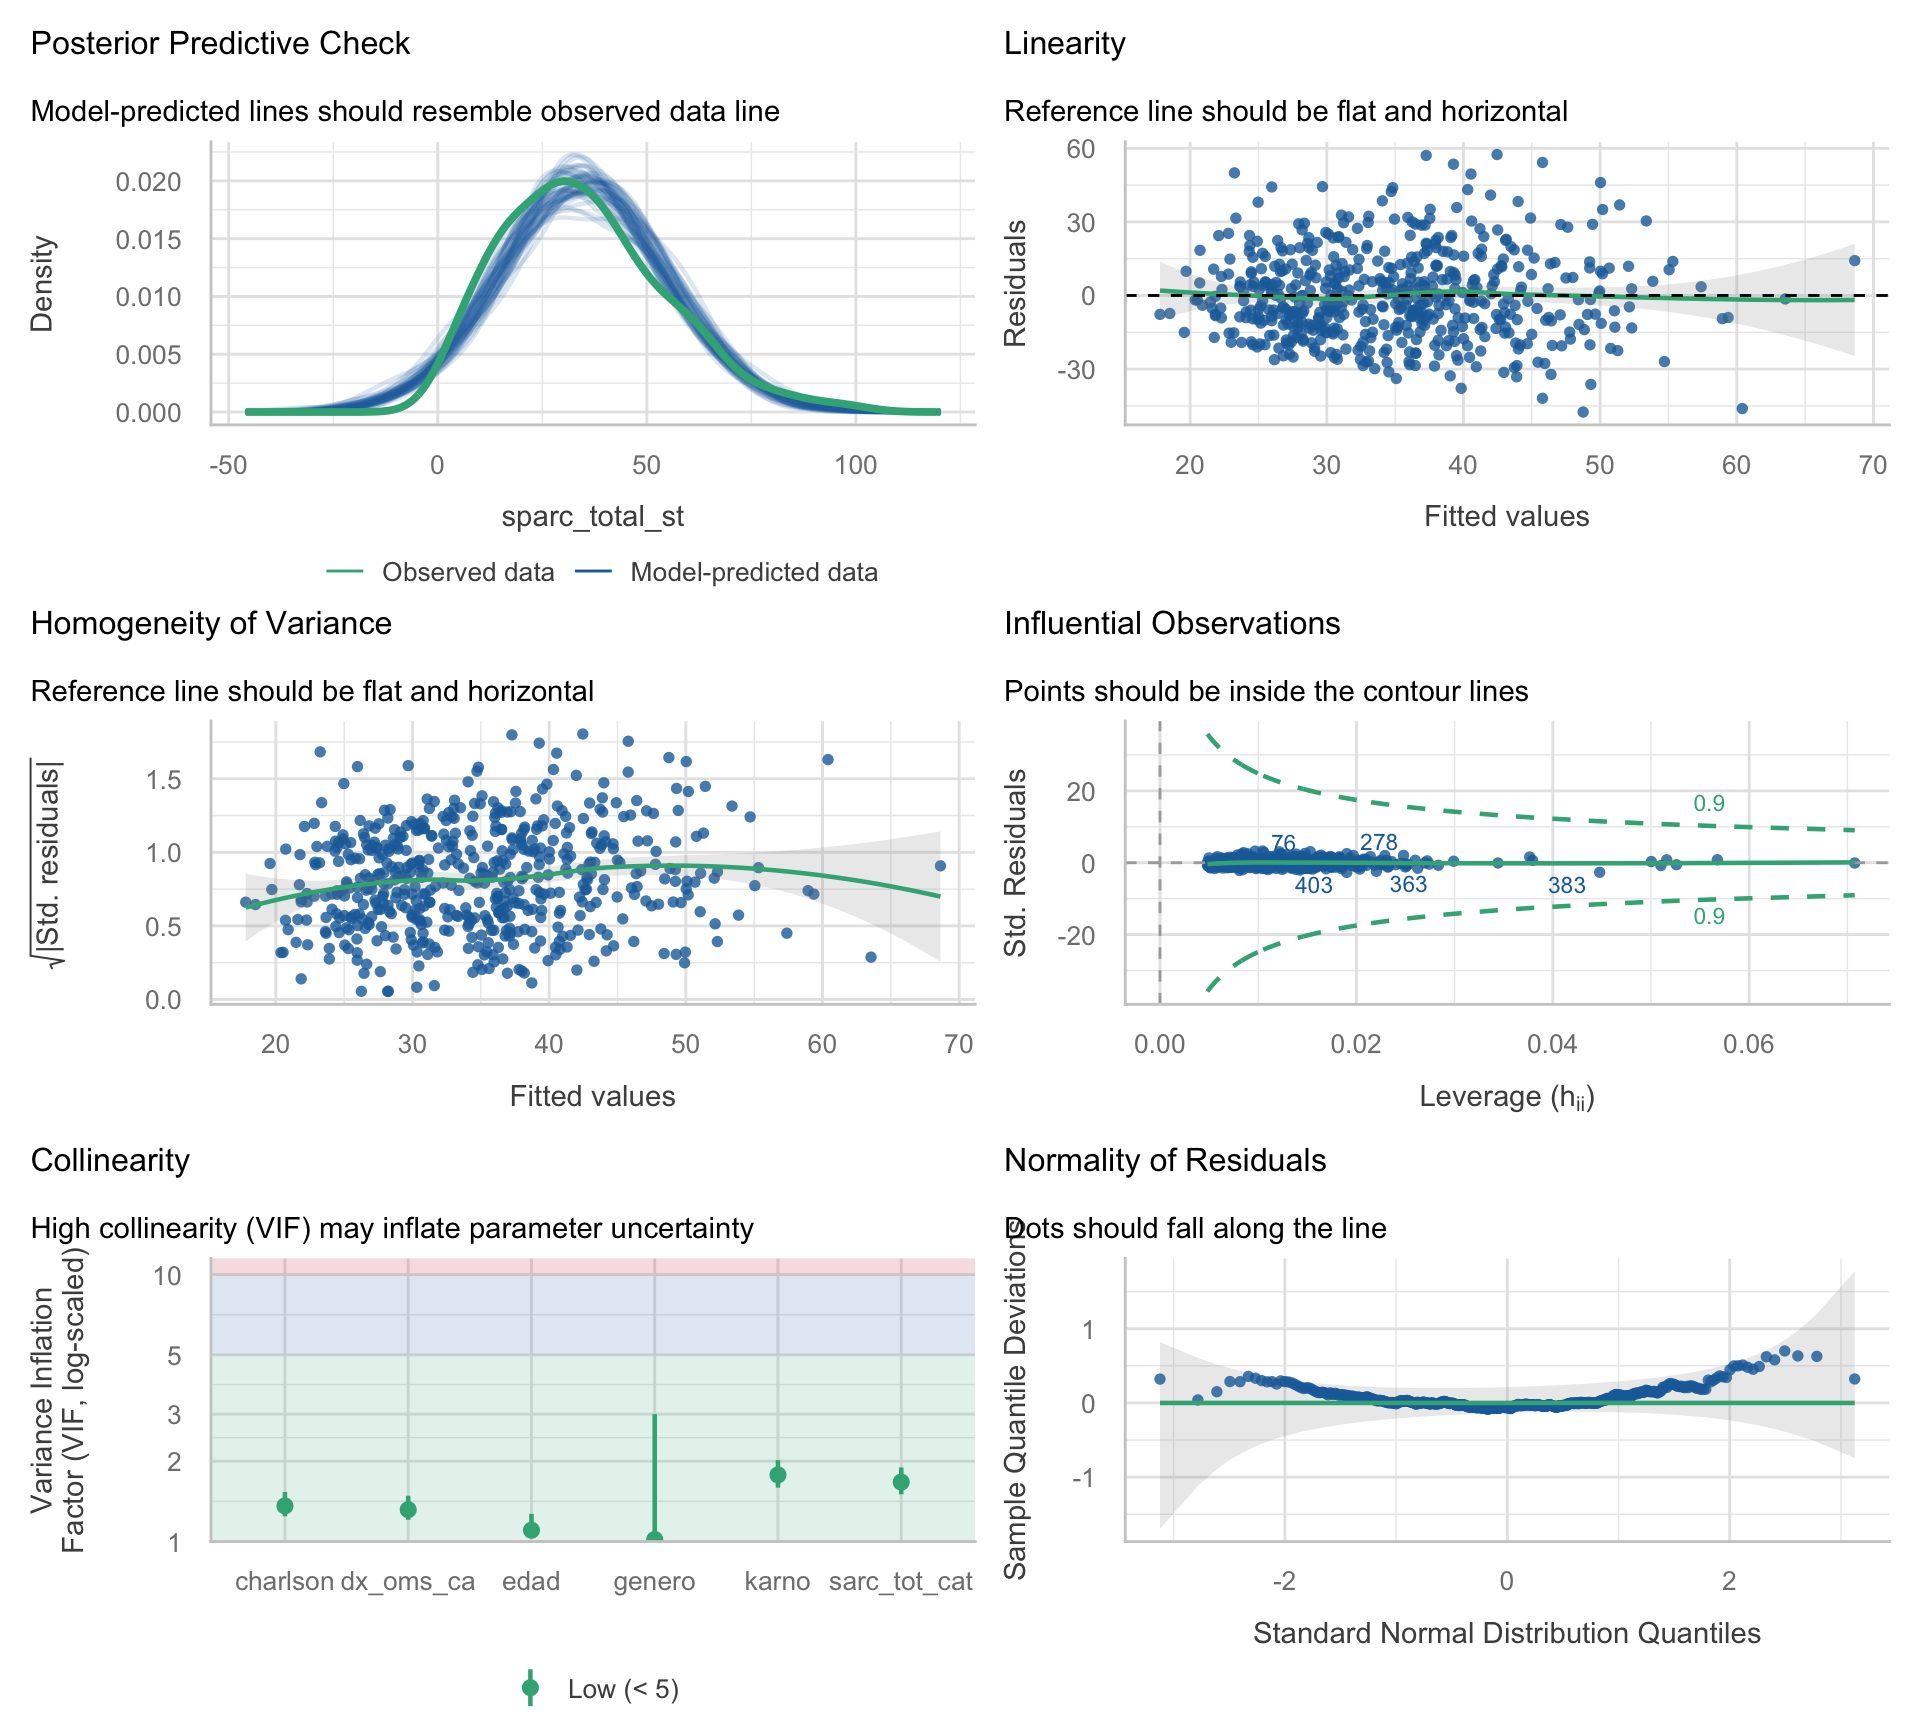
```{r}
#| label: modelo-2-supuestos
#| fig-width: 10
#| fig-height: 9
check_model(model2)
```
### Modelos por dominio: crudos y ajustados
Un modelo para cada dominio ponderado. La tabla muestra solo el efecto de la sarcopenia. La columna *Ajustado* usa las mismas covariables del modelo 2.
```{r}
#| label: modelos-dominio
ajustar_dominio <- function(var_p, ajustado) {
  rhs <- if (ajustado) paste("sarc_tot_cat +", covariables) else "sarc_tot_cat"
  lm(as.formula(paste(var_p, "~", rhs)), data = data)
}

tabla_modelos_dominio <- function(ajustado) {
  map(dominios$var_p, \(v) {
    tbl_regression(ajustar_dominio(v, ajustado), include = sarc_tot_cat)
  }) %>%
    tbl_stack(group_header = dominios$nombre)
}

tbl_merge(
  list(tabla_modelos_dominio(FALSE), tabla_modelos_dominio(TRUE)),
  tab_spanner = c("**Crudo**", "**Ajustado**")
)
```
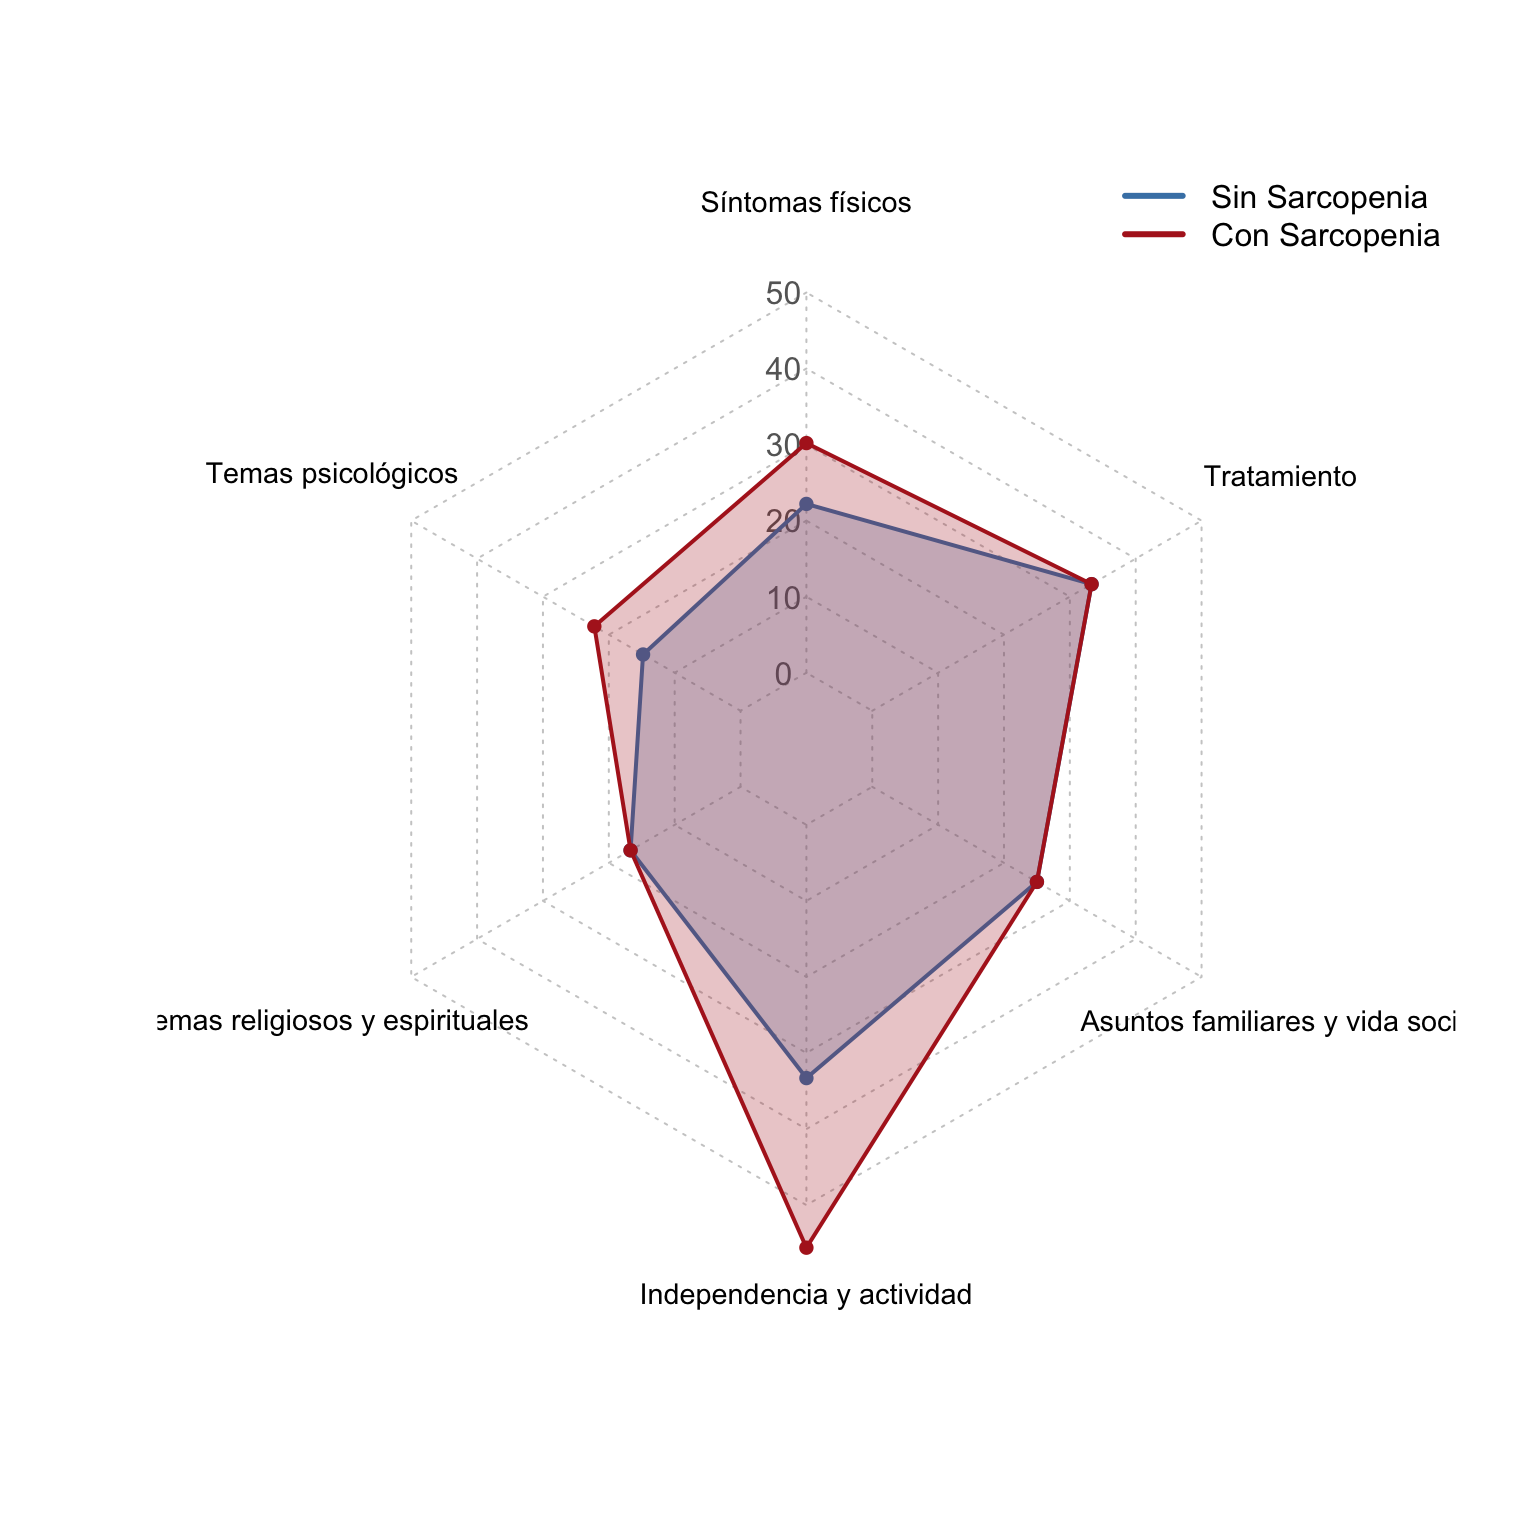
## 11. Objetivo 4 — Visualización: gráfico radar
Mediana del puntaje ponderado de cada dominio según sarcopenia.
```{r}
#| label: fig-radar
#| fig-width: 8
#| fig-height: 8
radar_group <- data %>%
  group_by(sarc_tot_cat) %>%
  summarise(across(all_of(dominios$var_p), ~ median(.x, na.rm = TRUE))) %>%
  rename_with(~ etiquetas_dominio[.x], all_of(dominios$var_p))

radar_group
eje_max <- 50   # extremo del eje radial (las medianas observadas son < 50)

radar_df <- bind_rows(
  as_tibble(set_names(as.list(rep(eje_max, 6)), names(radar_group)[-1])),
  as_tibble(set_names(as.list(rep(0, 6)),       names(radar_group)[-1])),
  radar_group[-1]
) %>%
  as.data.frame()

radarchart(
  radar_df,
  axistype    = 1,
  seg         = 5,
  caxislabels = seq(0, eje_max, length.out = 6),
  pcol        = col_sarc,
  pfcol       = scales::alpha(col_sarc, 0.25),
  plwd        = 2,
  plty        = 1,
  cglcol      = "grey80",
  axislabcol  = "grey40",
  vlcex       = 0.9
)

legend("topright", legend = names(col_sarc), col = col_sarc, lwd = 3, bty = "n")
```